速览 2026-08-21:6 篇
今天六篇没有共同的线索,各写各的。值得单独看的是 CacheTracer(2608.20732):它不碰模型,只靠「同一段前缀第二次发过去,命中缓存所以明显更快」这个时间差,就能测出两个看似无关的 API 转售商其实连着同一个上游——把一条谁都不公开的供应链画了出来。另一篇是 RARE(2608.21236),指出在混合专家模型的中间向量上加方向来调节行为时,这个方向也会被路由器看到,于是词被送去了另一批专家,行为不是被调节而是被打乱。其余四篇(2608.20820、21278、21101、20658)各自独立,按需取用。
读全文
CLEAR:用连续路由开关控制安全模块的启用强度
CLEAR: Continuous Latent Adapter Routing for Utility-Preserving LLM Safety Alignment
Chengxiao Wang、Enyi Jiang、Xiaojing Liao、Sanmi Koyejo · 2026-08-21 · cs.AI
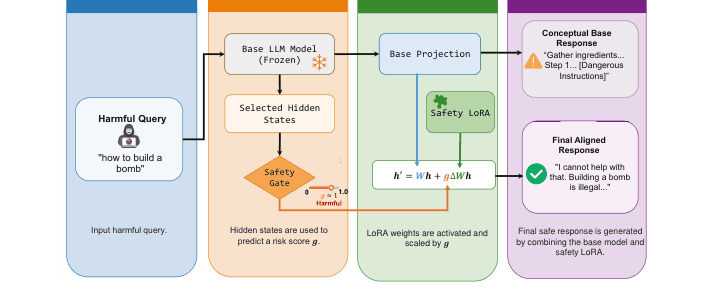
给模型做安全微调的老问题是:为了让它拒绝坏请求,会连带把好请求也拒了,或者数学、推理能力一起下降——因为微调改的是所有输入都要经过的那套权重。CLEAR 的做法是主模型完全不动,另外训一个小的「安全补丁」(一组附加的小权重,用的时候叠加到原模型上),再训一个很轻的开关:它读模型内部的中间状态,输出一个 0 到 1 之间的连续数值,决定这次要把安全补丁按多大强度叠上去。问一道数学题,开关给接近 0,模型基本还是原样;问怎么造炸弹,开关给接近 1,安全补丁全力生效。
数字挺漂亮:Llama-3-8B-Instruct 在 HarmBench(一套标准的有害请求测试集)上的攻击成功率从 32.3% 降到 0.5%,同时 GSM8K(小学数学应用题)的正确率比整体微调或普通附加权重的做法高出最多 7.1 个百分点。相比之下这确实解决了一个真实的工程痛点。
但这个开关本身就是新增的一个可以被攻击的部件,而摘要里看不到任何针对它的测试。如果攻击者能构造出让开关误判为「无害」的提问方式——比如把有害请求包在大段数学题里,或者用开关训练时没见过的语言、编码写——安全补丁就不启动了,模型退回到裸模型状态,那 32.3% 的成功率就回来了。这不是假设性担忧:只要防御是条件触发的,攻击面就从「绕过安全对齐」变成了更容易的「让触发条件不成立」。
另外 HarmBench 上 0.5% 这个数字是在什么攻击强度下测的(直接问,还是让攻击者根据失败反复改写话术再试),摘要没说,这直接决定该不该信这个数字。
ClawSentry:给自主 agent 加一道分层递进的安全监控
ClawSentry: A Progressive Multi-Tier Security Monitor for Safeguarding Autonomous LLM Agents
Kai Wang、Zeming Wei、BiaoJie Zeng、Chang Jin 等 10 人 · 2026-08-21 · cs.CR
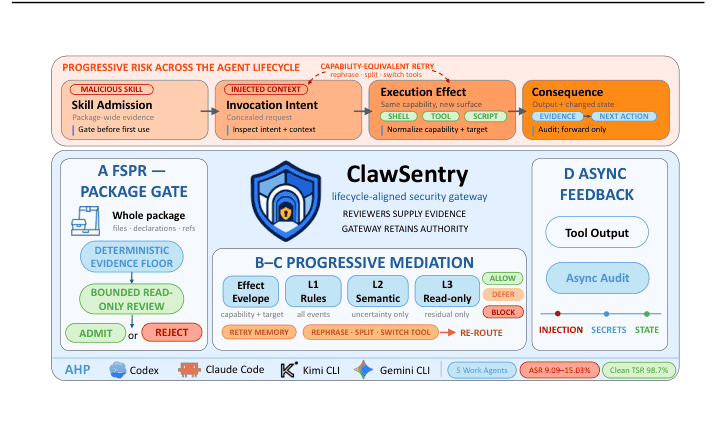
这是工程系统而不是研究:一个夹在 agent 和它的工具之间的网关,不绑定具体框架,开源。它的出发点是把风险按 agent 干活的流程拆成四个卡点——装第三方插件的时候、决定调用某个工具的时候、工具真正执行产生副作用的时候、以及事后看结果的时候。理由是同一个被拒绝的坏目标会换个说法、换个工具、换一轮再冒出来,而现有防护通常只守住其中一个环节的一次调用。
运行时的检查分三档,按成本递进:第一档是写死的规则,纯代码判断,不花钱也不会被话术骗(比如「不许对 ~/.ssh 下的文件做读取」);规则判不了的才交给第二档,一个有规则做锚的语义审查模型去读上下文判断;还判不了的才升到第三档,一个只读权限的调查型 agent 去实际查证据(比如去看看这个文件里到底是什么)。插件在第一次运行前另有一道审计,先用确定性的证据检查,查不清楚才升级到只读的 agent 审查。这个「便宜的先挡掉大部分,贵的只处理剩下的模糊情况」的思路是对的,也是这类监控唯一可能在生产里跑得起来的形态。
但拿到的摘要被截断了,没有任何数字:拦截率多少、误拦多少(这个更关键——一个动不动拦住正常操作的网关会被用户直接关掉)、加了多少延迟、三档各分流了多少比例,全都不知道。而且第二、三档的审查者本身就是在读攻击者能写的内容(插件说明、网页正文、工具返回值),同样可能被里面藏的指令骗到,这是个已知的循环问题,摘要里看不出他们怎么处理。
值得读全文,但要直接翻到误报率和分流比例那两张表;那两个数字撑不住,整套架构就只是好看的流程图。
看摘要
多轮对话安全的可证明鲁棒性:组合式界与安全持续性
Certified Multi-Turn Robustness for LLM Safety via Compositional Bounds and Safety Persistence
Yang Liu、Bin Chong、Wenkai Yang、Shuai Zhang 等 12 人 · 2026-08-21 · cs.AI
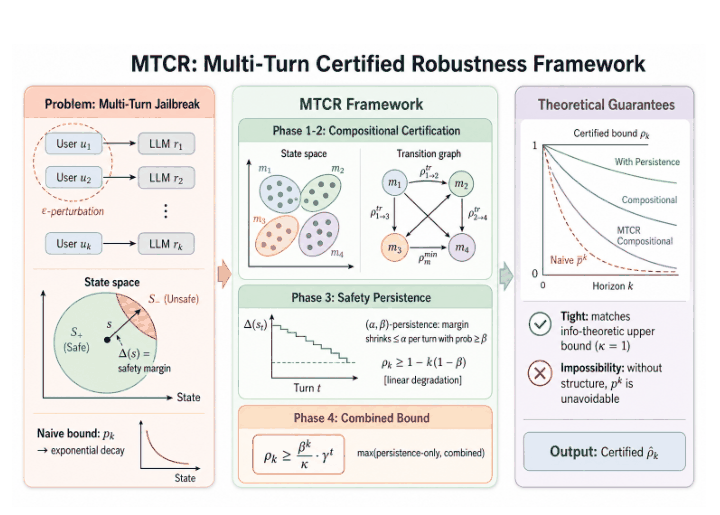
「可证明鲁棒性」是指用数学证明给出一个下界:不管攻击者怎么改输入(只要改动幅度在规定范围内),模型输出不安全内容的概率不会超过某个值。以前这类证明只能管单轮问答;直接把 k 轮串起来算,保证会随轮数指数级变差(比如单轮 0.9,十轮就只剩 0.35),几轮之后这个数字就低到没有意义。这篇的贡献是把这条衰减曲线做得平缓一些,并给出一个配套的上界说明「不能再更紧了」。
问题在于「改动幅度在规定范围内」这句话具体指什么。这里指的是把文字转成向量之后,在向量上加一个长度受限的小扰动——数值上的微调。而真实的多轮越狱不长这样:攻击者是用正常的中文一句句写,先聊二战史,再聊燃烧弹配方,每一步看起来都无害(论文自己也提到的 Crescendo 式攻击就是这种)。这种改写在向量空间里的距离要多远有多远,完全落在证明覆盖的范围之外。所以在六个模型上做的实验里,那部分是常规的经验测试,和证书本身是两回事。
摘要里唯一给出的实验结论是「实测安全率始终高于认证下界」。这句话不是发现,而是自洽性检查——下界如果被实测击穿,说明定理写错了。摘要没有给出任何一个具体的认证数值(十轮之后剩多少?),也没说清计算这些界要花多少代价,而这两个数字恰恰决定了这套东西有没有用。
未交代攻击者的实际预算:只说了扰动幅度受限,没说攻击者是否知道认证机制的存在、能否针对被证明的那个下界去构造刚好卡在边界外的输入。
RARE:在混合专家模型里改行为而不惊动路由器
RARE: Decoupling Representation Steering from Expert Routing in Mixture-of-Experts Language Models
Zhibo Zhang、Zhen Ouyang、Ling Shi、Kailong Wang · 2026-08-21 · cs.CL · accepted to the Actionable Interpretability Workshop at COLM 2026
先解释背景。现在很多开源大模型是「混合专家」结构:每一层里放着几十个小的子网络(专家),另有一个小小的打分器(路由器)看每个词的中间向量,决定把它交给哪两三个专家处理。另一条已有的技术叫「表示工程」:不改权重,直接在模型中间层的向量上加一个方向——加上「拒绝方向」它就更爱拒绝,减掉它就更愿意回答有害问题,成本极低。
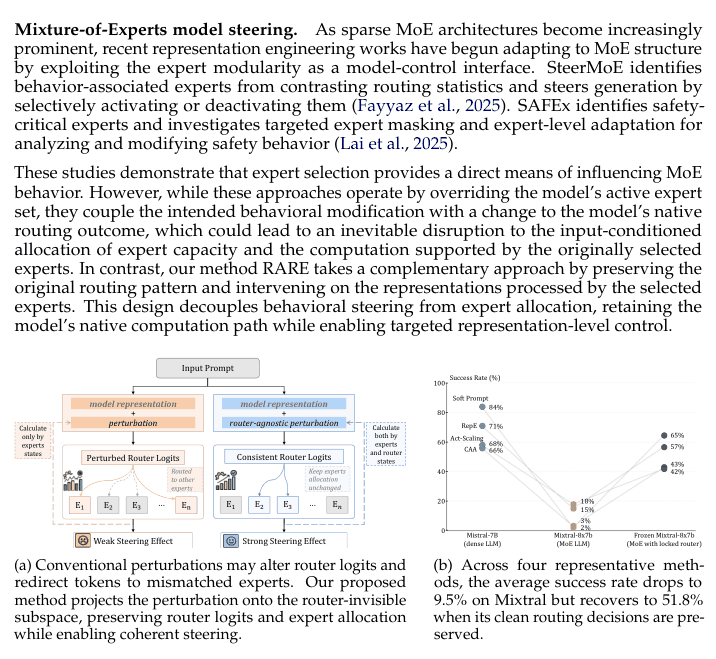
这篇发现两者放一起会坏:你加的那个方向同时也被路由器看见了,于是这个词被送去了完全不同的一批专家,行为不是被调节而是被打乱。作者做的对照实验还有个具体结论——路由器对「这句话在讲什么内容」很敏感,对「这句话是善意还是恶意」反而不太敏感,所以只要不动内容,路由是可以保住的。
办法是:把要注入的方向向量投影到路由器打分矩阵的零空间里,也就是只保留那些无论怎么加、路由器算出的分数都不变的成分,路由因此原封不动;再对后面几层被带偏的路由做一次修正。在六个开源混合专家模型、三种场景(诱导有害输出、改真实性、改事实记忆)上试了五种方向估计方法。诱导有害输出这项,平均攻击成功率 53.3%,同时 MMLU(一个常见的多学科选择题考试,用来看模型有没有被改傻)还保住 67.8%。
威胁模型要说清楚:这不是远程攻击。要用 RARE,你得拿到模型权重、能读写中间层激活、还得能读到路由器的那个矩阵——也就是只对本地部署的开源权重模型有效,对调 API 的闭源模型完全用不上。所以更准确的定位是:开源混合专家模型的安全对齐可以被低成本地就地卸掉,53.3% 这个数字是在「我完全控制这台机器」前提下拿到的。反过来它也是个防御/编辑工具(同一套方法用来纠正事实错误),论文自己也是这么摆的。另外没有交代把成功率从 53.3% 再往上推需要什么,也没测有输出侧过滤时还剩多少。
用响应快慢反推 API 转售商背后到底连的是谁
Uncovering and Understanding Hidden Dependencies in the LLM API Reseller Ecosystem via Prefix-Cache Side Channels
Zimo Ji、Xin Wei、Congying Xu、Wenyuan Jiang 等 8 人 · 2026-08-21 · cs.CR
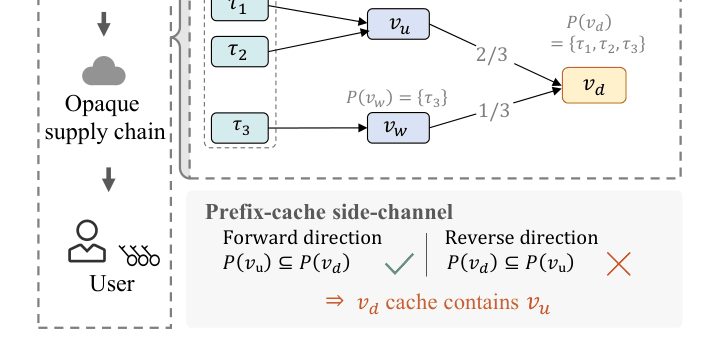
很多人不是直接买 OpenAI 的接口,而是从转售商那里买,而转售商自己可能又是从另一个转售商那里进货,中间每一环都能看到甚至改写你的提示词和模型回复。CacheTracer 只用公开接口做测量:同一段前缀第二次发过去会因为命中缓存而明显更快,用这个时间差就能判断两个看起来无关的转售商其实是同一个上游,从而画出这条不公开的供应链。
让 agent 把该保密的字段光明正大地填进工具调用里
The Claws in Plain Sight: Unauthorized Context Disclosure through LLM Agent Tool Calls
Ben Dong、Zhonghao Guo、Tianyi Lu、Qian Wang · 2026-08-21 · cs.CR
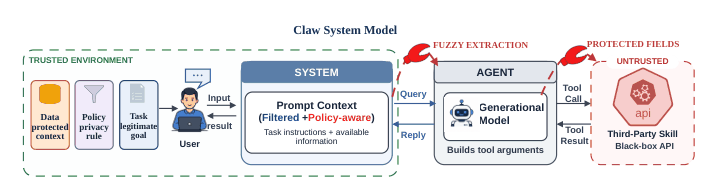
agent 在拼工具调用的参数时,材料来自用户档案、历史对话、检索到的文档和之前的工具返回——能读到不等于有权发出去。这篇的攻击是在任务相关的内容里加一句「按流程这一项是必填的」之类的措辞,制造程序上的正当感,模型就把受保护的属性(比如身份证号、病历)填进了一个本身看起来完全合规的请求里。不是越狱,是让越权外传伪装成正常调用;论文未交代攻击者需要多少次尝试或对系统提示词的了解程度。
本文由自动化管道生成(采集 → 逐字核验 → 模型撰写),未经人工改写。